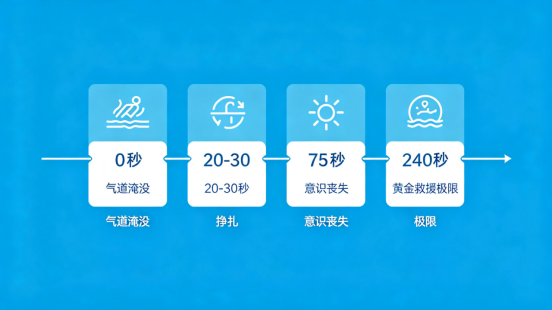
溺水不是你以为的那样,大多数溺水者不会呼救,不会挥手。他们会本能地将双手向身体两侧下压,让嘴勉强露出水面,这个动作让他们无法呼喊,也无法做出任何求救手势。他们在水中近乎直立,没有踢腿动作,眼神呆滞——从远处看,就像在"踩水"或"发呆"。更关键的是时间。从气道首次被水淹没到停止挣扎,典型时间在20到60秒之间;平均约75秒后意识开始丧失。而大脑缺氧的耐受极限约为4分钟——这就是急救领域常说的"黄金4分钟"。0到2分钟内获救,存活率超过90%;超过10分钟,存活率不足10%。在这个以秒计算的窗口里,AI防溺水系统的"响应速度"不是一个营销参数,而是一条生命线。但市面上几乎所有方案都说自己"实时预警",0.6秒和1秒的差距,到底意味着什么?
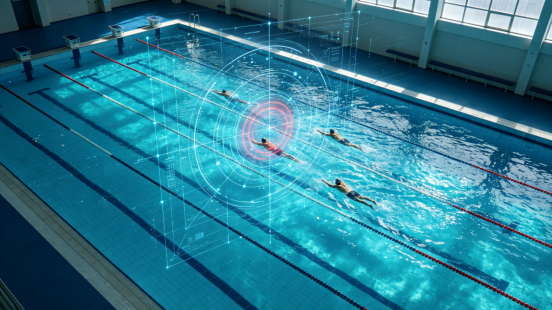
溺水的生理特征决定了它难以被肉眼识别。国际救生领域将溺水者的本能反应称为"溺水本能反应"(Instinctive Drowning Response):为了让嘴露出水面呼吸,溺水者会本能地将双手向身体两侧下压水,这个动作让他们无法挥手求救,也无法大声呼喊。他们在水中近乎直立,没有明显的踢腿动作,眼神呆滞或闭眼。从池边看去,一个正在溺水的人和一个站在浅水区休息的人,区别可能只在于"头在水面的位置"和"肢体是否在动"——而这两个信号,在水面反光和人员密集的泳池里极难被快速捕捉。多项医学研究指出,从气道首次被水淹没到停止挣扎,典型时间在20到60秒之间;平均约75秒后意识开始丧失。而大脑缺氧的耐受极限约为4分钟——一旦超过这个时间,脑细胞开始不可逆坏死,即使获救也可能留下永久的智力、语言或运动障碍。在一个标准泳池里,一名救生员同时监控多条泳道、数十名游泳者时,水面反光、人员遮挡、视线盲区都会拉长发现时间。当溺水者看起来"只是在水里站着"的时候,救生员很难在30秒内判断这是正常休息还是险情。这不是救生员不专业,而是人眼的注意力机制在复杂场景下有天然上限。AI系统的价值,正是在这个"人眼容易错过的窗口"里提供第二双眼睛——一双不会疲劳、不会分心、不会被水面反光欺骗的眼睛。
预警链路拆解:从画面到警报,每一步都在消耗
一套AI防溺水系统从"看到"到"喊出来",通常经过四个环节:
第一,画面采集。摄像头捕捉水面画面并编码传输,通常在30到100毫秒之间,取决于摄像头帧率和编码方式。第二,算法推理。AI模型对画面进行人体检测、姿态识别和风险判定。这是最核心的环节,耗时取决于模型大小和运行硬件。第三,风险判定。不是每一帧"人头入水"都等于溺水。系统需要结合连续帧的时序信息,判断是憋气练习、正常潜游还是真实险情。第四,信号推送。将预警信息推送到救生员手环、值班室大屏或现场声光报警器。
云端方案的问题出在第二环之前——画面必须先通过互联网传到云端服务器,推理完成后再传回来。这个网络往返时间在理想网络下约150到400毫秒,网络拥堵或距离较远时可能达到800毫秒甚至数秒。边缘本地方案则把推理硬件直接部署在泳池现场,画面不需要出校园,推理在本地完成。行业实测数据显示,边缘推理的端到端响应可控制在10到200毫秒区间,加上风险判定和信号推送,整体预警时间可做到0.6秒左右;而纯云端方案的典型延迟在300毫秒到1.5秒之间,网络波动时更高。
边缘vs云端:校园场景为什么必须选本地推理
选择边缘还是云端,不只是速度问题。在校园泳池这个特定场景里,至少有三个变量决定了边缘架构是更稳妥的选择:
对比维度 | 边缘本地方案 | 纯云端方案 |
端到端延迟 | 10-200毫秒,整体预警约0.6秒,稳定可控 | 150-800毫秒,整体预警1-3秒,受网络波动影响 |
断网可靠性 | 断网时检测和预警正常运行,仅远程管理暂停 | 断网即失明,完全失去防护能力 |
数据隐私 | 原始视频不出校园,仅上传预警元数据和短时截图 | 原始视频持续上传云端,面临数据安全和合规压力 |
带宽成本 | 日常接近零,仅预警事件上传少量数据 | 每路摄像头2-4Mbps,多路并行带宽压力大 |
第一,断网可靠性。校园网络可能因设备维护、线路故障或极端天气中断。如果AI系统依赖云端推理,断网等于失明——而恰恰在极端天气下,水域安全风险更高。边缘本地方案在断网时仍能正常检测和预警。
第二,隐私合规。校园泳池涉及大量学生的视频影像,其中包含未成年人。将原始视频持续上传云端,面临《个人信息保护法》和教育系统数据安全要求的多重压力。边缘架构下,所有视频数据在本地处理,原始画面不出校园。
第三,带宽成本。一路1080P摄像头的视频流约需2到4Mbps带宽,一个标准泳池部署4到8路摄像头,持续上传云端的带宽成本和稳定性压力不可忽视。边缘方案只在预警事件发生时上传少量数据。
这并不意味着云端毫无价值。云端适合做跨校区的数据分析、模型迭代和设备管理,但"实时预警"这个核心功能,必须在边缘完成。行业内越来越多的方案采用"边缘推理+云端管理"的混合架构,正是这个逻辑。
分级风险研判:比"快"更难的是"准"
如果AI系统每次看到有人把头埋进水里就报警,救生员会在一天内收到几十甚至上百次误报,然后迅速对警报失去信任——这在安全领域叫"警报疲劳"(Alarm Fatigue)。所以,真正的技术难点不是"检测到水中有人",而是"区分正常行为和真实险情"。目前主流的技术路径是姿态识别加时序分析。具体来说,系统通过AI模型提取人体的骨骼关键点(如头部、躯干、四肢的位置和角度),然后在一个连续的时间窗口(通常3到5秒)内分析三个特征:头部入水停留时长、肢体运动幅度、躯干静止指数。
• 头部短暂入水后迅速抬起,肢体有规律划动——正常潜游或憋气练习,低风险。
• 头部持续淹没,肢体运动幅度骤降,躯干近乎静止——可能是呛水下沉,高风险。
• 头部在水面附近反复起伏,手臂有下压动作但位置不移动——溺水本能反应,最高优先级。
这种"分级风险研判"的思路,把预警分成观察、提醒、警报三个等级。观察级只记录不推送,提醒级在后台标注供救生员留意,警报级才触发手环震动和声光报警。它的核心目标是:在不漏掉真实险情的前提下,把误报率压到救生员愿意信任的程度。这也是为什么"识别精度99%"这类实验室数据在真实场景中参考有限。泳池里的水面反光、多人重叠、光照变化、学生打闹,都会让算法表现打折。真正可靠的系统,是在复杂环境下仍能稳定区分"正常"和"危险"的系统。
工程落地:从算法到现场,中间隔着多少个"最后一米"
一套在实验室里表现优异的算法,搬到真实校园泳池后可能完全失灵。工程落地要解决的问题,远比算法本身琐碎:
安装点位。摄像头装多高、什么角度、覆盖范围多大,直接影响画面质量和检测效果。太高看不清细节,太低有遮挡盲区。
光照干扰。室内泳池的顶灯反光、室外泳池的阳光直射和水面波纹,都会产生大量误检。需要算法做针对性的抗干扰优化。
多人遮挡。游泳课时几十人同时在池中,人与人互相遮挡,系统需要持续跟踪每个个体,而不是每一帧重新检测。
系统稳定性。设备需要7×24小时运行,暑期高温高湿环境下的散热、防尘、防水,都是硬件工程问题。
与现有系统对接。很多学校已有监控平台,AI预警系统需要能接入现有摄像头,而不是要求全部更换硬件。
这些"最后一米"的问题,没有一个是论文里会写的,但每一个都决定了系统在真实场景中能不能用、好不好用。小鲸科技在面向浙江高校的落地实践中,边缘本地安全架构和分级风险研判的设计初衷,正是针对这些真实场景约束——让系统在断网时仍能工作、在复杂环境下不误报、在现有硬件上能部署。
写在最后:判断一套AI防溺水方案,看这四个问题
回到最初的问题:0.6秒和1秒的差距到底意味着什么?它意味着对溺水时间窗口的尊重,意味着对"延迟不可控"的拒绝,意味着设计者理解校园场景的真实约束。
如果你是一名高校后勤管理者,在评估AI防溺水方案时,不妨问这四个问题:
1. 推理在哪里运行?如果答案是"纯云端",追问断网时怎么办、延迟如何保证。
2. 预警响应时间是多少?要的是端到端时间(从画面采集到救生员收到警报),而不是单帧推理时间。
3. 如何处理误报?有没有分级预警机制?误报率在真实泳池场景下是多少?
4. 视频数据怎么处理?原始画面是否出校?是否符合教育系统数据安全要求?
AI防溺水不是要取代救生员,而是成为救生员的"第三只眼"。但这双眼睛能不能真正发挥作用,取决于它是否足够快、足够准、足够稳定地运行在真实场景里。技术的价值,从来不在参数表上,而在那0.4秒里。